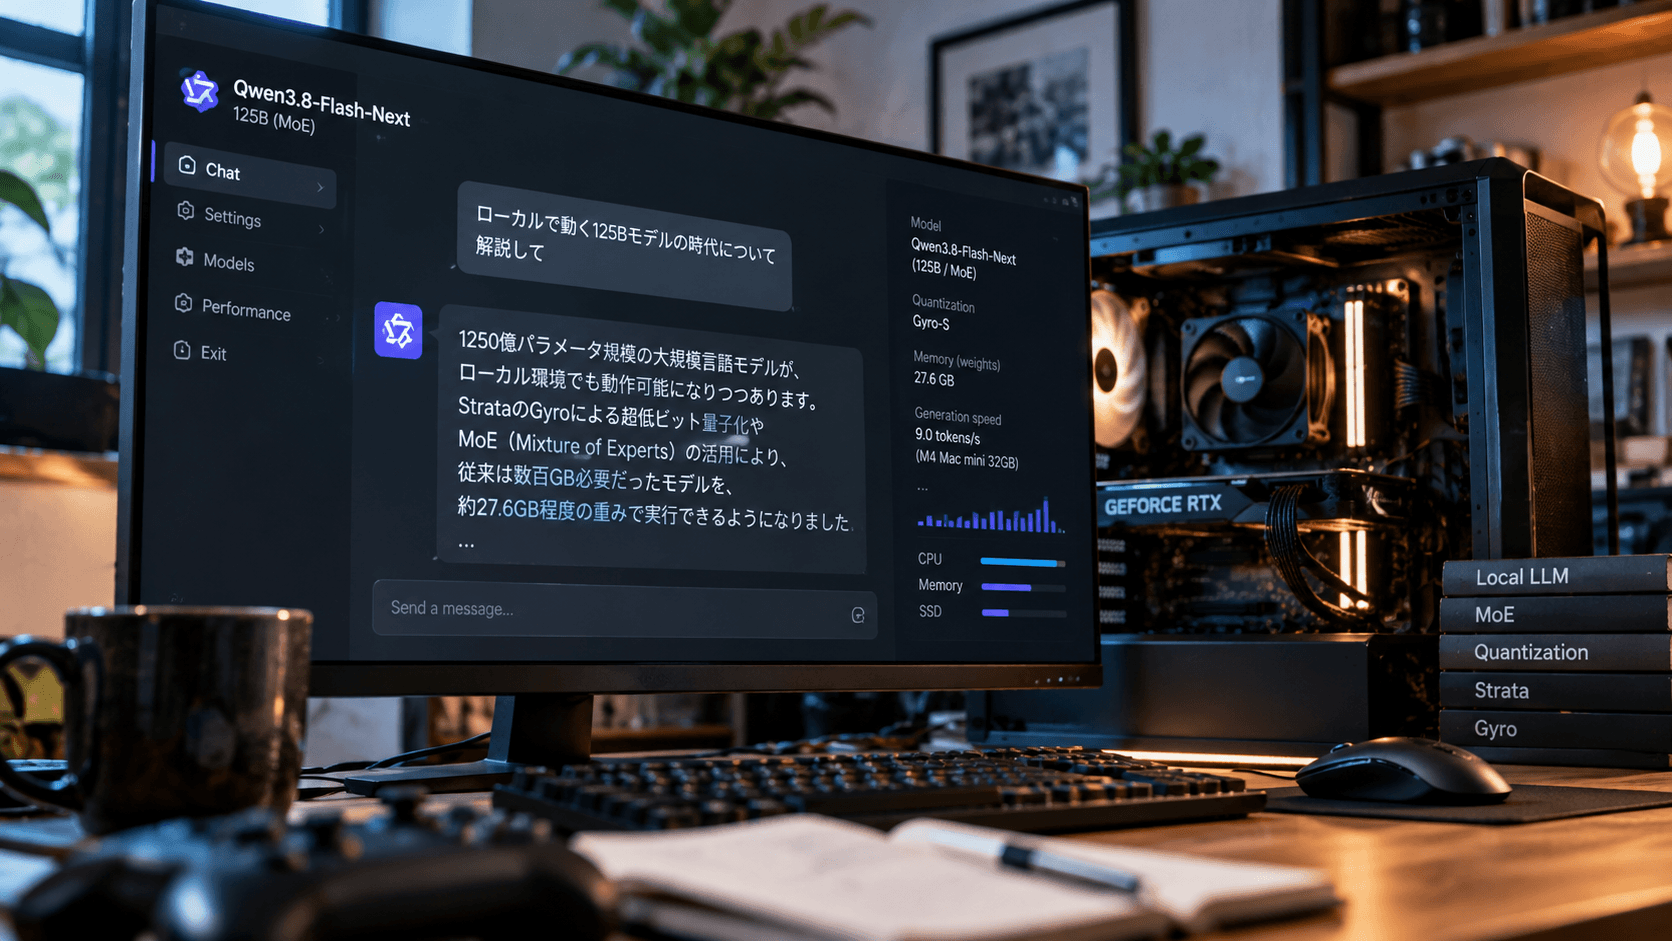
1,250億(125B)ものパラメータを持つ巨大LLMが、手元のゲーミングPCで動く。少し前ならハイエンドPCでも扱いに苦労した規模のモデルが、身近なハードウェアで動作する時代が近づいている。
オープンソースのローカルLLM実行環境「Strata」は、10月20日にバージョン0.2.1、翌21日には0.2.2をリリースした。今回注目したいのは、超低ビット量子化技術「Gyro」への対応と、その実行環境の拡大である。
対象となるのは、125Bパラメータの大規模MoEモデル「Qwen3.8-Flash-Next」だ。通常、FP16(16bit浮動小数点)で125Bの重みを保持するだけでも約250GBのメモリが必要になるが、Gyro-Sでは実行時に必要な重みのメモリ容量を約27.6GBまで削減している。
これにより、システムRAMとGPUのVRAMを合計して32GB程度という、比較的身近なPC構成でも起動が視野に入る。
これだけ聞くと、ローカルLLMの常識を覆すブレイクスルーにも思える。
しかし、自作PCユーザーとしては気になるところも多い。これほど極端に圧縮して回答品質は維持できるのか。そして、何よりまともな速度で動作するのだろうか。
今回は、この技術の仕組みと実用性をハードウェアの観点から掘り下げていこう。
125Bを約27.6GBに圧縮。鍵を握るのはMoEと超低ビット量子化
まず、125Bというモデルがどれほど大きいのかを整理しておきたい。
単純計算では、125Bの重みをFP16で保持すると約250GB、4bit量子化(Q4)でも約62.5GBが必要になる。実際には量子化方式ごとの管理情報や実行時のバッファも必要になるため、要求メモリはこれより大きくなる場合がある。
なお、Qwen3.8-Flash-Nextには125Bの本体とは別に51Bパラメータ相当のn-gram埋め込みテーブルも存在する。したがって、モデル全体の容量を考える場合は、このデータも無視できない。
こうした巨大なモデルを一般的なPCでも扱えるようにするのが、今回のGyroだ。
Gyroはagentionaiが開発した量子化方式で、Hadamard(アダマール)変換とトレリス符号化を組み合わせ、MoEモデルのExpert部分の重みを非常に小さな容量で表現している。
ここで重要なのが、Qwen3.8-Flash-Nextに採用されているMoE(Mixture of Experts)という構造だ。
一般的なDenseモデルでは、各トークンの処理で基本的にモデル全体の重みを使用する。一方、MoEは多数のExpertから必要なものを選択して処理するため、総パラメータ数に対して演算量を抑えやすい。
実際、Qwen3.8-Flash-Nextは125Bという規模でありながら、1トークン当たりのアクティブパラメータ数は約6Bとされている。
ただし、MoEだから必要なメモリがそのまま6B相当になるわけではない。次のトークンでどのExpertが選ばれるかは変わるため、使われていないExpertの重みも、どこかに保持しておく必要がある。
そこでGyroによる圧縮と、Strataによるメモリ管理が効いてくるわけだ。
さらにStrataでは、約28.8GBのn-gramテーブルをSSD上に保持し、必要な部分を推論中に読み出す方式を採用している。
そのため、Gyro-Sのダウンロードサイズは58.5GBあるものの、実行時にRAMとVRAMへ読み込む重みの公称容量は約27.6GBに抑えられている。
つまり、モデル全体を魔法のように27.6GBまで縮めたわけではない。量子化による圧縮とSSDの活用を組み合わせることで、メモリ使用量を大幅に削減しているのである。
「メモリ32GBで動く」の落とし穴。容量と速度は別問題
ここで注意したいのが、Strataの掲げるメモリ要件だ。
32GBという数字は、基本的にシステムRAMとGPUのVRAMを合計した容量を指す。WindowsなどのOSが使用する領域に加え、推論時にはKVキャッシュやワークバッファも必要になるため、32GBあれば必ず快適に動作するという意味ではない。
例えば、システムRAM32GBにGeForce RTX 3060(VRAM12GB)を組み合わせたPCなら、合計44GBとなる。
Strataのモデル選択では、Windowsやシステム向けに約5GBを差し引く考え方が用いられており、この構成なら単純計算で約39GBが目安になる。Gyro-Sの公称要件である27.6GBは十分に下回っている。
ただし、これはあくまで容量面での話だ。
PCに詳しい読者ならご存じの通り、DDR4やDDR5のシステムメモリと、GPUに搭載されたGDDR6などのVRAMでは、帯域幅に大きな差がある。
GPUのVRAMにすべての重みを保持できなければ、システムRAMからPCIeを経由してデータを転送する必要が生じる。さらにGyroではSSD上のn-gramテーブルも参照するため、ストレージの読み出し性能やアクセス遅延も無視できない。
もちろんStrata側も、こうした問題を軽減するためにExpertのキャッシュやデータ転送の最適化を行っている。
それでも、メモリ容量を節約できることと、メモリ帯域や転送遅延の問題を解決できることは別の話だ。
もっとも、32GBでの動作が単なる理論値というわけでもない。
開発元は、ユニファイドメモリ32GBを搭載したM4 Mac miniでGyro-Sを動作させ、約9トークン/秒という結果を報告している。SSDへのストリーミングを伴う条件ではあるが、少なくとも実際に文章を生成できることは確認されている。
9トークン/秒なら、高速とは言えないものの、用途によっては十分に対話が成立する速度だろう。
ただし、これは特定のMac環境における開発元の測定結果だ。WindowsとGeForceを組み合わせたPCでも同じ速度が出るとは限らない。
125Bという数字に惑わされてはいけない。極端な量子化の代償
筆者として最も気になるのは、やはり量子化による回答品質への影響である。
Strataの公式資料によると、Gyro-Sは従来の低ビット量子化形式「IQ2_XS」と比較して使用するメモリ容量を約24%削減できる一方、KLダイバージェンスで評価した誤差は約13%大きくなっている。
KLダイバージェンスとは、簡単に言えば、元のモデルと量子化後のモデルが出力する確率分布の違いを測る指標だ。一般に小さいほど元のモデルに近いが、実際の回答品質をそのまま表す数字ではない。
より精度を重視したGyro-Mでは、必要メモリが約35GBに増える代わりに、IQ3_XXSに近い量子化品質を実現しているという。
ところが、ここで興味深いデータがある。
開発元が実施した60問の推論テストでは、Gyro-Mが49問正解だったのに対し、従来のQ2_0は57問正解を記録している。
Gyro-Mは別の量子化誤差測定ではQ2_0より良好な結果を示しているにもかかわらず、このテストでは正答数が下回ったのである。
もちろん、60問という限定的なテストでモデル全体の優劣を決めることはできない。出題内容や評価方法によっても結果は変わるだろう。
それでも、量子化誤差が小さいからといって、実際の推論タスクでも必ず優秀とは限らないという点は押さえておきたい。
LLMは次に生成するトークンを確率的に選択しながら文章を組み立てる。量子化によって出力確率が変化すれば、その後の文章や推論過程にも影響が及ぶ可能性がある。
極端に量子化された125Bモデルよりも、14B〜32B程度の小規模モデルを高精度の量子化で動かしたほうが、特定の用途では良好な結果を得られることも十分考えられる。
ただし、モデル間の回答品質は元々の学習性能や得意分野にも左右されるため、単純に量子化ビット数やパラメータ数だけで比較することはできない。
125Bという数字は確かに魅力的だ。しかし、重要なのはそのモデルが実際にどれだけ正確で、有用な回答を返してくれるかである。
GPUの演算性能だけでは決まらない。重要になるメモリ階層
ゲーミングPCの性能を考える際、GPUコアの演算性能やメモリ帯域は重要な指標だ。
しかし、ローカルLLMでは少し事情が異なる。
特に、文章を1トークンずつ生成するデコード処理では、GPUが重みデータをどれだけ効率よく読み出せるかが性能を大きく左右する。
もちろん、バッチサイズやモデル構造によっては演算性能がボトルネックになることもあるため、すべてがメモリ帯域だけで決まるわけではない。
Strataでは、GPUのVRAM上にMoEのExpertをキャッシュし、収まりきらないExpertをシステムRAMから必要に応じて転送する仕組みを採用している。
この構造では、一般にVRAM容量が大きいほど多くのExpertを保持でき、PCIe経由の転送を減らしやすくなる。
逆にVRAM容量が小さいGPUでは、Expertの切り替えに伴うデータ転送が増え、GPUの演算性能を十分に生かせない場面も考えられる。
いくら高性能なGPUを搭載していても、必要なデータが届かなければ演算ユニットは待たされてしまうわけだ。
今回のGyroは、そこへさらにSSDというストレージ階層を組み合わせた。
ただし、SSDから全Expertを毎回読み込むというわけではない。Expertのキャッシュや転送の仕組みと、n-gramテーブルのSSD参照は区別して考える必要がある。
このように、ローカルLLMではGPU単体の性能だけでなく、VRAM容量、システムRAM、PCIe帯域、ストレージ、そして推論エンジンの実装までが性能に関わってくる。
自作PCユーザーにとっては、なかなか面白い時代になってきた。
Strata 0.2.2ではIntel ArcやMacにも対応。NVIDIA以外の選択肢も広がる
10月21日に公開されたStrata 0.2.2では、対応環境の拡大やGPU向けの最適化も進められた。
Gyroは従来のNVIDIAやAMD環境に加え、Linux上のIntel Arc、さらにApple Silicon搭載Macでも利用できるようになっている。
NVIDIA向けにはGyroのExpert処理を最適化するカーネル改善も導入された。
開発元のRTX 3060(12GB)を使った測定では、Gyro-Sのデコード速度が54.3トークン/秒から62.5トークン/秒へと約15%向上したという。
この数値は特定の条件における測定結果であり、すべてのPCで同等の速度や改善率が得られるわけではない。それでも、推論エンジン側の最適化だけで性能が改善する余地があることを示している。
Intel ArcについてはArc A750を中心に検証されており、Gyroの実行には対応するSYCLエンジンが必要となる。Macについても対応はまだ新しく、Gyro-Mのエンドツーエンド動作など、十分な検証が行われていない条件が残っている。
つまり、すべての環境で問題なく動作する完成されたソフトウェアという段階ではない。
それでも、ローカルLLMの実行環境としてNVIDIA製GPU以外の選択肢が増えていることは歓迎したい。
特に大容量のユニファイドメモリを搭載できるMacやRyzen AI Max系のPCは、VRAM容量の制約を受けやすいローカルLLMと相性のよい構成になり得る。
ただし、ユニファイドメモリも容量が大きければ無条件で速くなるわけではない。メモリ帯域やGPU性能、実装の最適化によって実際の性能は大きく変わる。
結局のところ、ハードウェアとソフトウェアの両方を見極めることが重要なのである。
技術としては高く評価したい。ただし、これを目的にPCを組む必要はない
StrataとGyroの取り組みは、ローカルLLMの可能性を広げる技術として高く評価できる。
従来から量子化やCPUオフロードによって巨大モデルを動かす方法は存在したが、今回のGyroはさらに少ないメモリで125Bクラスのモデルを扱えるようにした点が興味深い。
しかも、32GBのMac miniで実際に文章を生成できているのだから、単なる実験的なアイデアにとどまっているわけでもない。
一方、筆者としては、これからローカルLLM用のPCを組むのであれば、Gyro-Sの最低動作要件を目標にパーツを選ぶことはおすすめしない。
極端な量子化による回答品質への影響や、VRAM・RAM・SSD間のデータ転送による制約は依然として残っている。
日常的なコーディング支援や文章生成など、応答速度を重視する用途であれば、まずは14B〜32Bクラスのモデルを余裕のあるメモリ環境で動かす構成から考えるほうが合理的だろう。
もちろん、回答品質まで小規模モデルのほうが優秀とは限らない。用途ごとの比較は必要だが、少なくとも扱いやすさと速度の面では有力な選択肢となる。
しかし、既存のゲーミングPCを使って125Bという巨大モデルを動かしてみたいのであれば、Gyroは非常に面白い。
今回の技術で何より評価したいのは、これまで大容量メモリの搭載に頼っていた問題に対して、量子化技術と推論エンジンの工夫で新たな解決策を示したことだ。
もちろん、メモリ帯域やストレージのアクセス遅延といった物理的な制約がなくなったわけではない。
それでも、高価なGPUや大容量メモリを追加する以外にも、ソフトウェアの改良によってローカルLLMの実行環境を改善できる余地があるというのは、PC好きとしてなかなか痛快な話である。
そして、こうした工夫がさらに洗練されれば、今は性能面で妥協が必要な構成でも、将来的には実用性が高まる可能性がある。
ローカルLLMの世界では、もはやパラメータ数やGPUの演算性能だけを見ていても、その実力は判断できない。
モデルの構造、量子化方式、メモリ帯域、推論エンジンの最適化。これらをどれだけうまく組み合わせられるかが重要になってきている。
ハードウェアの性能向上だけでなく、ソフトウェア側の工夫でもできることが増えていく。
今回のStrataとGyroは、その面白さを改めて感じさせる技術といえるだろう。
参考資料
メモリ選びを確認
DDR世代・容量・枚数はこれで合っている?
DDR4/DDR5の違いや、用途に合う容量、安定しやすい構成を確認できます。
メモリ互換ガイドを見るGearTuneをチェックして最新ニュースをお見逃しなく。