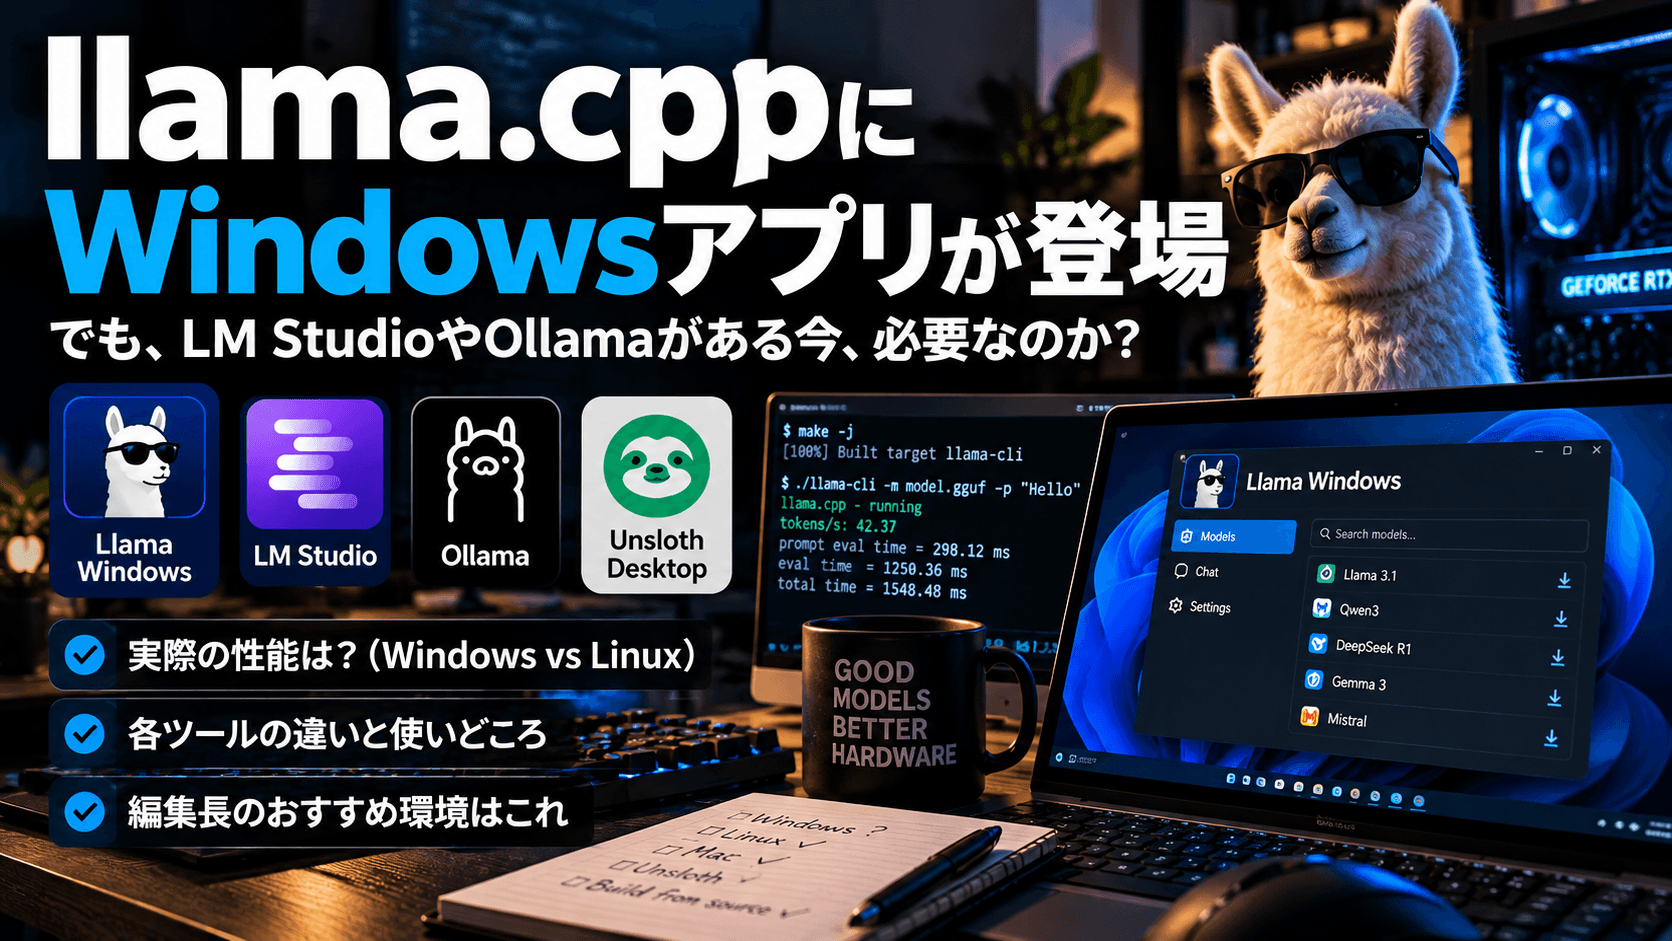
Hugging Faceは10月13日、llama.cppをWindows 11上で手軽に利用できる無料アプリ「Llama Windows」を公開した。
タスクトレイから操作でき、Hugging Face上のモデルをワンクリックでダウンロードして実行できる。コマンド操作やビルドも不要で、Windows on ArmやNVIDIA RTX Sparkにも対応する。
これまでllama.cppの導入に苦労していたユーザーには朗報だろう。
LM StudioやOllamaとの違いは?
しかし、WindowsでローカルLLMを手軽に動かすだけなら、すでにLM StudioやOllamaが存在する。
さらに、2026年8月にはUnsloth Desktopも登場しており、モデルの実行だけでなくファインチューニングなどにも対応している。
Llama Windowsの特徴は、llama.cppを直接扱える軽量なフロントエンドであることだ。既存のllama.cpp環境を利用できるほか、モデルの管理や実行をGUIから操作できる。
一方、機能面で既存アプリを置き換えるほどの優位性があるかは疑問が残る。
Windows版llama.cppはLinuxより遅い?
GearTune編集部では、これまでWindowsとLinuxの両環境でllama.cppをビルドし、同一構成で性能を比較してきた。
その結果、Windowsネイティブ版はLinux版と比較して、推論速度が大幅に低下するケースを繰り返し確認している。
もちろん、これは編集部の検証環境における結果であり、すべてのGPUやバックエンドで同様の差が生じるとは限らない。
ただ、ローカルLLMの性能を最大限引き出したいのであれば、Windows向けGUIの利便性だけでなく、実行環境そのものを見直す価値はある。
Windowsを使い続けたいならWSL2も選択肢になるし、メモリ消費まで抑えたいなら軽量なLinuxを直接起動する方法もある。
編集部としては、結局Linuxでビルドするのが一番
編集部としては、WindowsでローカルLLMを本格的に動かすメリットをあまり感じていない。普段はLinuxかMacを使用しており、Windowsで新しいモデルを試す場合もUnsloth Desktopを選ぶことが多い。
Ollamaは手軽な反面、細かな設定や実行環境の自由度に物足りなさを感じる。それならllama.cppを自分でビルドした方が早い、というのが正直なところだ。
LM Studioについても、Linux版は比較的安定している印象がある一方、Windows版ではRadeon系GPUのドライバーやAPIが認識されず、何度も苦労した経験がある。
もちろんUnsloth Desktopも万能ではない。Linux版については完成度に不満があり、Linuxを使うなら結局、好きなプルリクエストやブランチのllama.cppをビルドして使う方が自由度も高い。
そもそも編集部の検証では、同一構成でもWindowsネイティブ版のllama.cppがLinux版より大幅に遅くなるケースを何度も確認している。
そのため、個人的にはローカルLLMを本格的に使うならLinux、あるいはMacを選びたい。
一方、Windowsで初めてローカルLLMを動かすなら、現時点ではUnsloth Desktopがおすすめだ。
Llama Windowsの登場によって選択肢が増えること自体は歓迎したいが、既存ツールから乗り換えるほどの魅力があるかは、もう少し見極めたいところだ。
GearTuneをチェックして最新ニュースをお見逃しなく。