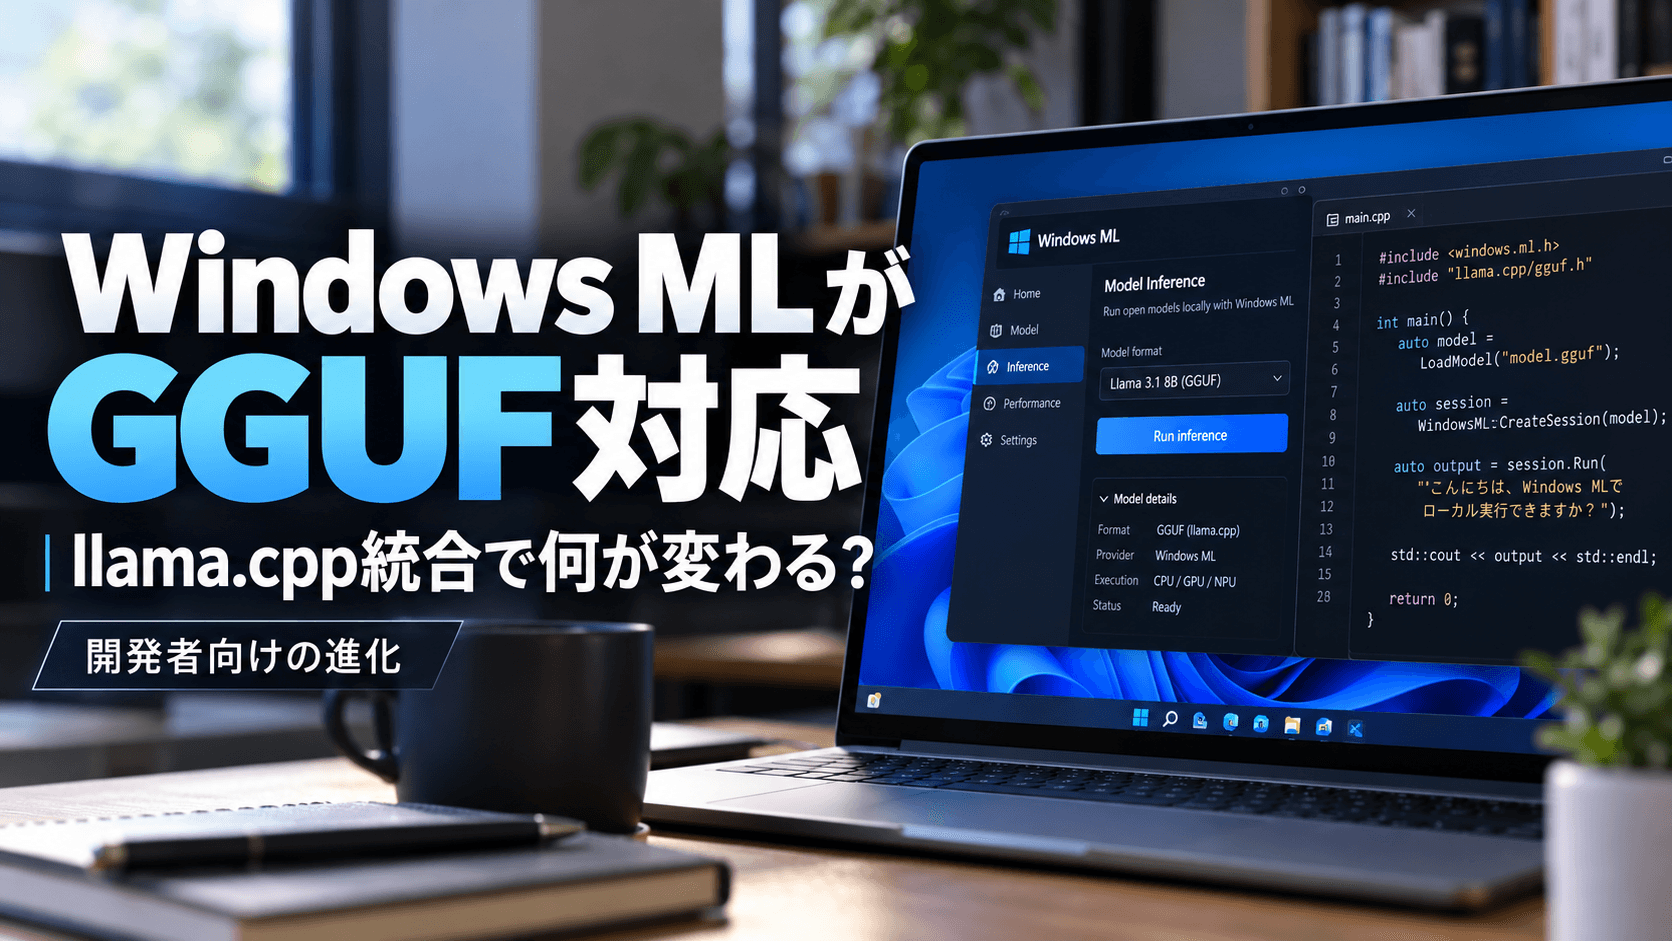
Microsoftは2026年10月7日、Windows向けローカルAI推論基盤「Windows ML」において、llama.cppの実験的なサポートを開始した。
これにより、従来のONNX形式に加えて、ローカルLLMで広く普及しているGGUF形式のモデルをWindows MLから実行できるようになった。
すでにLM StudioやOllamaなどの実行環境は存在するが、今回のアップデートは少し意味合いが異なる。
WindowsそのもののAI開発基盤が、GGUFを扱えるようになったのだ。
Windows MLでGGUFが使えると何が変わる?
Windows MLは、CPUやGPU、NPUを利用してローカルAIを実行するためのMicrosoft製フレームワークだ。
これまでは主にONNX形式のモデルを扱ってきたが、今回の更新ではllama.cppを推論バックエンドとして利用できるようになった。
つまり、開発者は同じWindows MLのAPIから、ONNXとGGUFの両方を扱える。
さらに、新しいText Generation APIを使えば、テキスト生成に必要なトークン処理なども共通の仕組みで実装できる。
OpenAI互換のローカルAPIサーバーも用意されており、既存のAIクライアントから利用する構成も可能だ。
今後、WindowsアプリへのローカルLLM機能の組み込みが容易になる可能性がある。
LM StudioやOllamaは不要になる?
結論から言えば、現時点では不要にならない。
LM StudioやOllamaは、モデルのダウンロードや管理、実行を手軽にするためのツールだ。
一方、Windows MLはアプリケーション開発者向けの推論基盤であり、そもそも役割が異なる。
また、今回のGGUF対応は実験的な段階だ。
Microsoftの資料によれば、GGUFのCPU実行には対応するものの、GPUアクセラレーションには追加のバックエンドが必要となる。
現時点で公式に検証されているllama.cppバックエンドはCPUとNVIDIA CUDAであり、GGUFモデルのNPU実行には対応していない。
さらにText Generation APIでは、temperatureやtop-k、top-pによるサンプリング、投機的デコードなどもまだ利用できない。
普段からローカルLLMを使うユーザーが、今すぐWindows MLへ乗り換える理由はほとんどないだろう。
Windowsでllama.cppが速くなるわけではない
もう一つ注意したいのが性能だ。
Windows MLがllama.cppに対応したからといって、Windowsでの推論速度が自動的に向上するわけではない。
GearTune編集部では、これまで同一構成のWindowsとLinuxでllama.cppをビルドし、Windowsネイティブ版の推論速度が大幅に低下するケースを繰り返し確認している。
もちろん、これは編集部の検証環境における結果であり、すべてのGPUやバックエンドに当てはまるものではない。
今回のWindows ML統合についても、従来のllama.cppやLinux版との直接比較はまだできていない。
推論性能を重視するなら、引き続きOSやGPUバックエンドを含めた実行環境の検証が重要になるだろう。
編集部としては、WindowsのAI基盤としての進化に期待
個人的には、ローカルLLMを本格的に動かすなら、今でもLinuxやMacを選びたい。
ただし、Windows MLのGGUF対応そのものは歓迎すべき進化だ。
開発者が推論バックエンドの違いを意識せず、WindowsアプリにローカルAI機能を組み込みやすくなる意義は大きい。
特に、将来的にAMDやIntelなどのGPU、NPUへの対応が充実すれば、WindowsのローカルAI環境はさらに使いやすくなるだろう。
今回の更新は、既存のLLM実行ツールを置き換えるものではなく、Windowsアプリ全体でローカルAIを活用するための土台作りと言えそうだ。
GearTuneをチェックして最新ニュースをお見逃しなく。